AWSのDR戦略4種をRTO/RPOで比較|バックアップ&リストアからマルチサイトまで
リージョン全体が使えなくなるような大規模障害に備えるのが、災害対策(DR:Disaster Recovery)です。AWS では代表的な4つの戦略があり、「どれだけ早く復旧したいか」と「いくら払えるか」のバランスで選びます。
まず RTO と RPO を区別する
- RTO(目標復旧時間):障害が起きてから、サービスを再開するまでに許される時間
- RPO(目標復旧時点):どの時点までのデータを失ってよいか。「RPO 1時間」なら、直近1時間分のデータ消失は許容
覚え方:RTO は「止まっている時間(Time)」、RPO は「失うデータの量(Point)」。どちらも小さいほど高コストです。
4つの戦略を比較
| 戦略 | DRリージョンの状態 | RTO / RPO | コスト |
|---|---|---|---|
| バックアップ&リストア | バックアップだけを保管。障害時にゼロから構築 | 数時間〜 | 最も安い |
| パイロットライト | DB などの中核だけ常にレプリケーション。アプリサーバーは停止(または未作成) | 数十分〜 | 安い |
| ウォームスタンバイ | 縮小版の完全な環境が常に稼働。障害時にスケールアップ | 数分 | 高め |
| マルチサイト(アクティブ/アクティブ) | 本番と同規模の環境が両方で稼働し、トラフィックを処理 | ほぼゼロ | 最も高い |
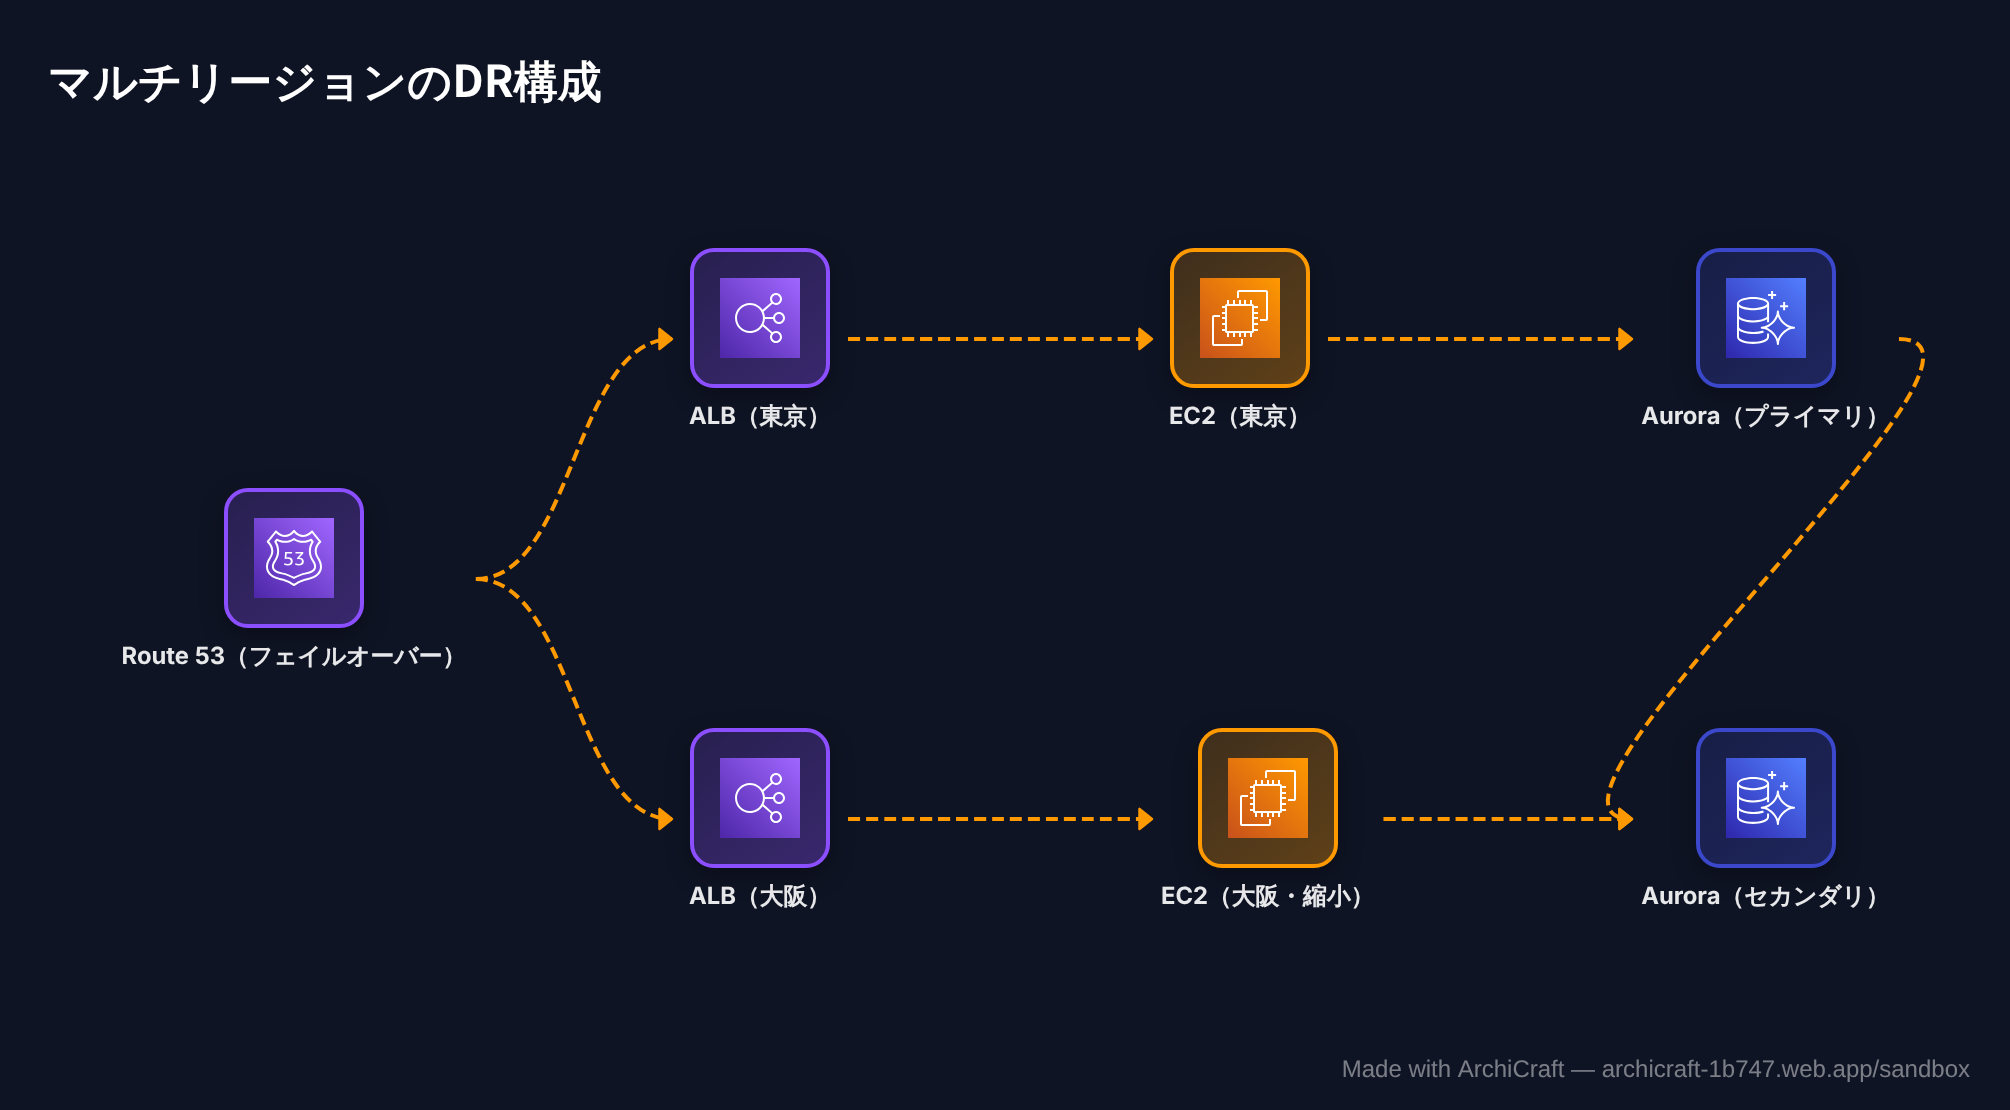
上の構成図は、大阪側に縮小した EC2 が常に動いているウォームスタンバイの例です。大阪の EC2 を止めて DB のレプリケーションだけを残せばパイロットライトになります。
見分け方のコツ:「中核のDBだけ動かしておく」→ パイロットライト、「縮小版がすべて動いている」→ ウォームスタンバイ。問題文の「最小限」「縮小した」という言葉に注目します。
DR を支える AWS サービス
- Route 53 フェイルオーバールーティング:ヘルスチェックでプライマリの異常を検知し、DNS の応答をセカンダリに切り替える
- Aurora Global Database:リージョン間のレプリケーション遅延が通常1秒未満。セカンダリリージョンを短時間で昇格できる(RPO 秒単位・RTO 分単位)
- DynamoDB グローバルテーブル:複数リージョンで読み書きできるマルチアクティブ構成
- S3 クロスリージョンレプリケーション(CRR):オブジェクトを別リージョンのバケットに自動コピー
- AWS Backup:EBS・RDS・EFS などのバックアップを一元管理し、別リージョンへコピー
- AWS Elastic Disaster Recovery:サーバーを継続的にレプリケーションし、低コストで素早く復旧
理解度チェック:「RPO 数秒・RTO 1分以内、かつ DB 以外はできるだけコストを抑えたい」。適した組み合わせは?
Aurora Global Database + パイロットライト(またはウォームスタンバイ)。DB は秒単位でレプリケーションし、アプリ層は障害時に Auto Scaling で起動します。RTO 1分を厳密に守るならウォームスタンバイ寄りにします。
まとめ
- RTO=止まる時間、RPO=失うデータ。小さいほど高い
- 安い順に バックアップ&リストア → パイロットライト → ウォームスタンバイ → マルチサイト
- 切り替えは Route 53、DB は Aurora Global Database / DynamoDB グローバルテーブル