ALB+EC2+RDSの3層Webアーキテクチャを構成図で理解する【SAA頻出】
「可用性の高いWebアプリケーションを設計せよ」——SAA(ソリューションアーキテクト アソシエイト)で最もよく出るのが、この3層Webアーキテクチャです。プレゼンテーション層(ALB)・アプリケーション層(EC2)・データ層(RDS)の3つに分け、それぞれを複数のアベイラビリティゾーン(AZ)にまたがって配置します。
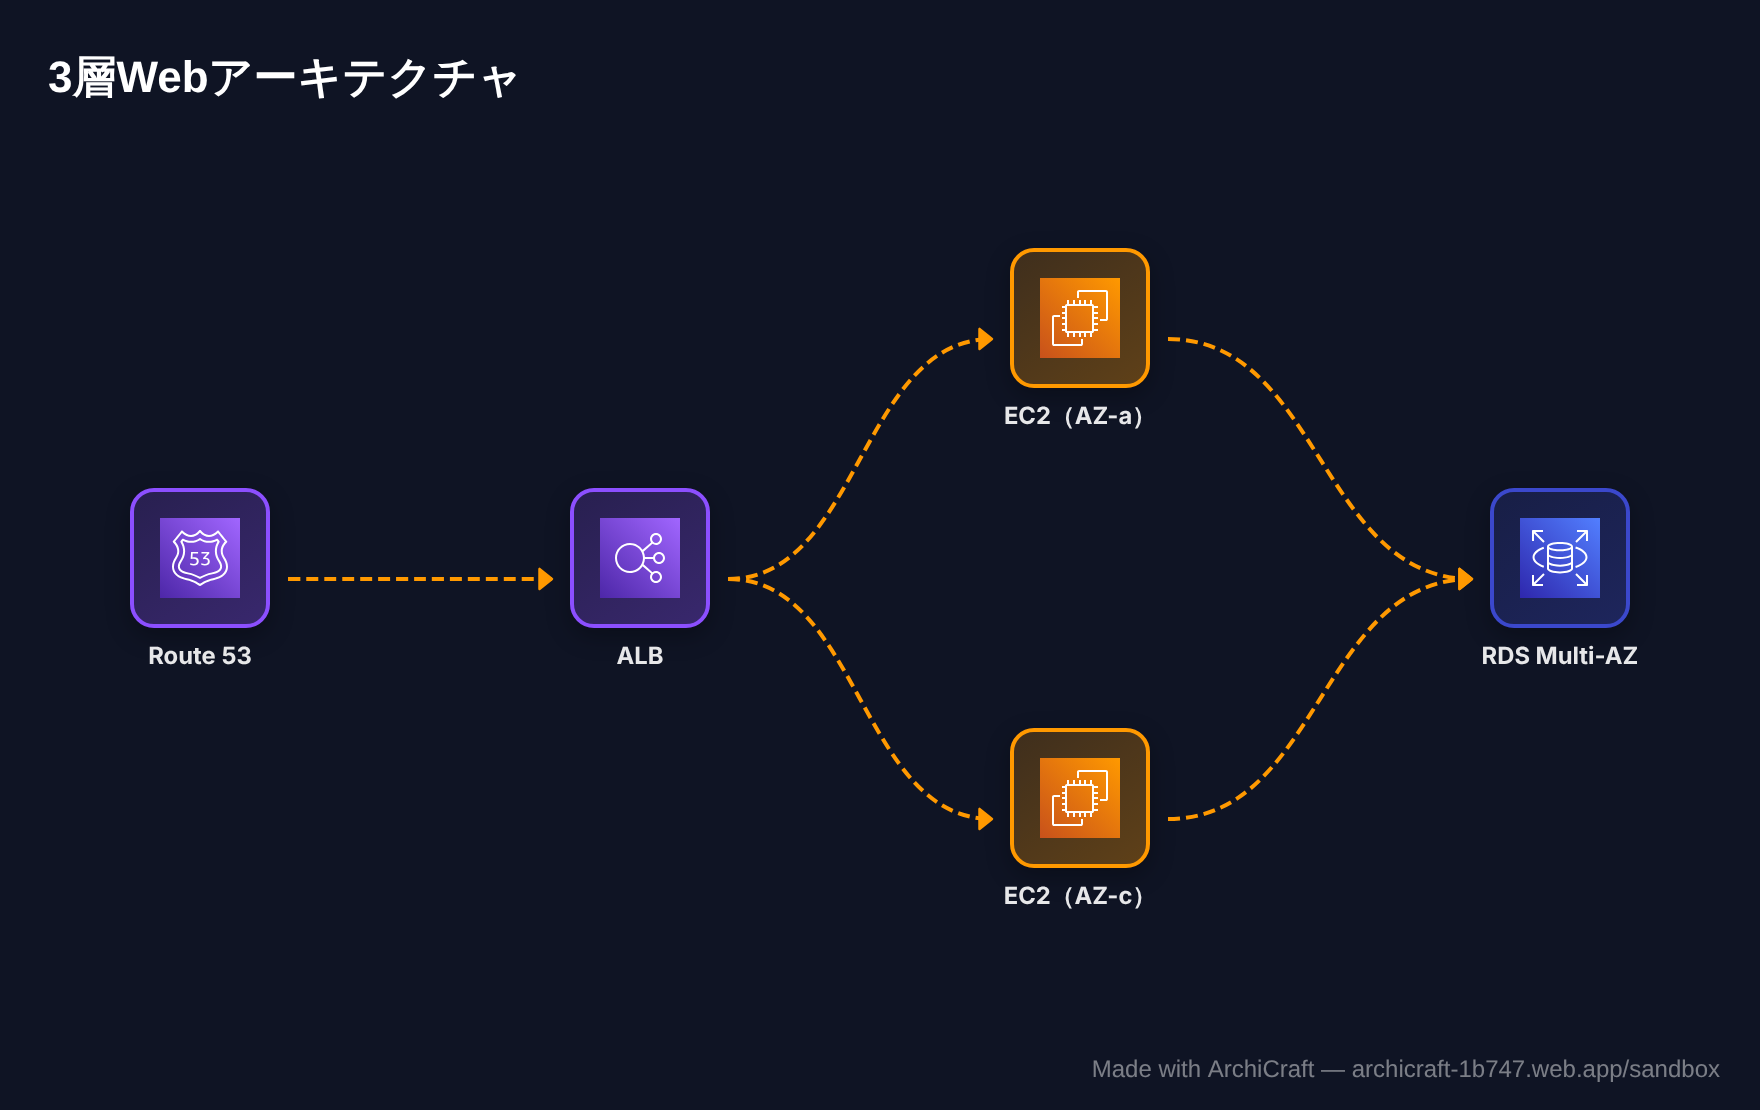
3つの層と役割
| 層 | サービス | 役割 | 冗長化のしかた |
|---|---|---|---|
| 入口 | Route 53 / ALB | 名前解決・リクエストの振り分け | ALB は作成時に2つ以上のAZのサブネットを指定する |
| アプリ | EC2(Auto Scaling グループ) | ビジネスロジックの実行 | 複数AZにインスタンスを分散し、台数を自動調整 |
| データ | RDS(Multi-AZ) | データの永続化 | 別AZにスタンバイを同期レプリケーション |
ポイント1:EC2 は Auto Scaling グループで複数AZに置く
EC2 を1台だけ置くと、そのインスタンスや AZ の障害でサービス全体が止まります。Auto Scaling グループに複数AZのサブネットを指定しておけば、インスタンスが異常になったときに自動で入れ替わり、負荷に応じて台数も増減します。
- ヘルスチェックの種類を
ELBにすると、「OSは動いているがアプリが応答しない」状態も検知して置き換えられる - 最小台数を2以上・2AZ以上にしておくのが高可用性の基本
- EC2 はプライベートサブネットに置き、インターネットからは ALB 経由でのみ到達させる
ポイント2:セッションをEC2に持たせない
台数が増減する構成では、ログイン情報などのセッションを EC2 のメモリに持つと、別のインスタンスに振り分けられたときに消えてしまいます。選択肢は次の2つです。
- スティッキーセッション:ALB が同じユーザーを同じ EC2 に送り続ける。手軽だが、そのインスタンスが落ちるとセッションは失われる
- 外部のセッションストア:ElastiCache や DynamoDB にセッションを保存する。EC2 がステートレスになり、スケールしやすい
試験のコツ:「インスタンスが入れ替わってもユーザーがログアウトされないようにしたい」なら、答えは ElastiCache / DynamoDB にセッションを外出しする案です。
ポイント3:RDS Multi-AZ とリードレプリカの違い
データ層の冗長化で最もよく問われるのが、この2つの使い分けです。
| Multi-AZ(インスタンス配置) | リードレプリカ | |
|---|---|---|
| 目的 | 可用性(障害時のフェイルオーバー) | 読み取り性能のスケール |
| レプリケーション | 同期 | 非同期 |
| スタンバイへの読み取り | できない | できる |
| 障害時 | 自動でフェイルオーバー(エンドポイントは同じ) | 手動で昇格させる |
なお、2つの読み取り可能なスタンバイを持つ「Multi-AZ DB クラスター」という配置もありますが、試験では上の表の違いを押さえておけば十分です。
よくあるひっかけ:「読み取り負荷が高いので Multi-AZ を有効にする」は誤りです。Multi-AZ のスタンバイは読み取りに使えません。読み取りのスケールにはリードレプリカ(またはキャッシュ)を使います。
単一障害点(SPOF)を探してみよう
構成図を見るときは「この1つが壊れたら全体が止まるものはどれか」を探すのが近道です。上の図で、次のように変えると SPOF が生まれます。
- EC2 を1つのAZにだけ置く → AZ障害で全停止
- RDS を Single-AZ にする → DB障害で全停止(復旧に時間がかかる)
- ALB を使わず、EC2 の Elastic IP に直接 DNS を向ける → そのインスタンスが SPOF
理解度チェック:「コストを抑えつつ、AZ障害でもサービスを継続したい」。最小構成は?
ALB(2AZ)+ Auto Scaling グループ(2AZ、最小2台)+ RDS Multi-AZ。EC2 を1台ずつ2AZに置けば、AZ障害時も残りの1台で処理を継続でき、Auto Scaling が台数を回復します。
まとめ
- 各層を複数AZに分散させるのが基本
- EC2 は Auto Scaling + ELB ヘルスチェック、セッションは外出し
- RDS は「可用性 → Multi-AZ」「読み取り性能 → リードレプリカ」